第5节:用 SQLite 数据库替换写死的假数据
前面几天我们已经把电影推荐网站跑起来了,但所有电影数据都硬编码在 main.py 里,既不便于维护,也无法动态增删。今天这一步,我们要把假数据"搬家"到 SQLite 数据库中,并让接口从数据库读取数据。
整体链路:删除硬编码数据 → 编写初始化脚本建库建表 → 可视化验证数据 → 改造接口查询逻辑 → 启动测试 → 新增数据验证动态效果。
一、清理 main.py 中的硬编码数据
打开项目中的 main.py,可以看到电影数据全部写死在文件里。我们把这部分整体删除,后续统一由数据库提供数据。
数据库选型上,关系型数据库(MySQL、PostgreSQL、SQLite 等)都可以胜任。MySQL/PostgreSQL 需要额外安装和配置,而 SQLite 轻量、免安装、就是一个文件,Python 内置 sqlite3 模块即可操作,非常适合本教程。因此本节课选用 SQLite。
二、编写初始化脚本:建库、建表、插入数据
在项目目录下新建 init.py,用于一次性把电影数据写入数据库。
操作数据库的流程是统一的:连接数据库 → 创建游标对象 → 执行增删改查 → 提交并关闭。可以这样理解:连接是修好通往数据库的"高速公路",游标就是路上来回运送数据的"小货车"。
1. 连接数据库并创建游标
import sqlite3

# 连接数据库(不存在则自动创建 movies.db 文件)
connection = sqlite3.connect('movies.db')
# 创建游标对象
cursor = connection.cursor()
2. 删除旧表并创建新表
为保险起见,先删除可能存在的旧表,再创建新表:
# 删除数据表
cursor.execute('DROP TABLE IF EXISTS movies')

# 创建新的数据表
cursor.execute('''
    CREATE TABLE movies (
        id INTEGER PRIMARY KEY,
        title TEXT,
        year TEXT,
        tags TEXT,
        score REAL,
        desc TEXT,
        bg TEXT,
        director TEXT,
        actors TEXT,
        video_url TEXT
    )
''')
3. 循环插入数据(使用占位符防 SQL 注入)
把原来的 movies_data 拷贝过来,用 for 循环逐条插入。字段值使用 ? 占位符,再传入真实值,可有效防止 SQL 注入:
# 插入数据
for movie in movies_data:
    cursor.execute('''
        INSERT INTO movies(id, title, year, tags, score, desc, bg, director, actors, video_url)
                   VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
    ''', (
        movie['id'],
        movie['title'],
        movie['year'],
        movie['tags'],
        movie['score'],
        movie['desc'],
        movie['bg'],
        movie['director'],
        movie['actors'],
        movie['video_url']
    ))
4. 提交、关闭并打印结果
connection.commit()
connection.close()
print("数据库操作成功")
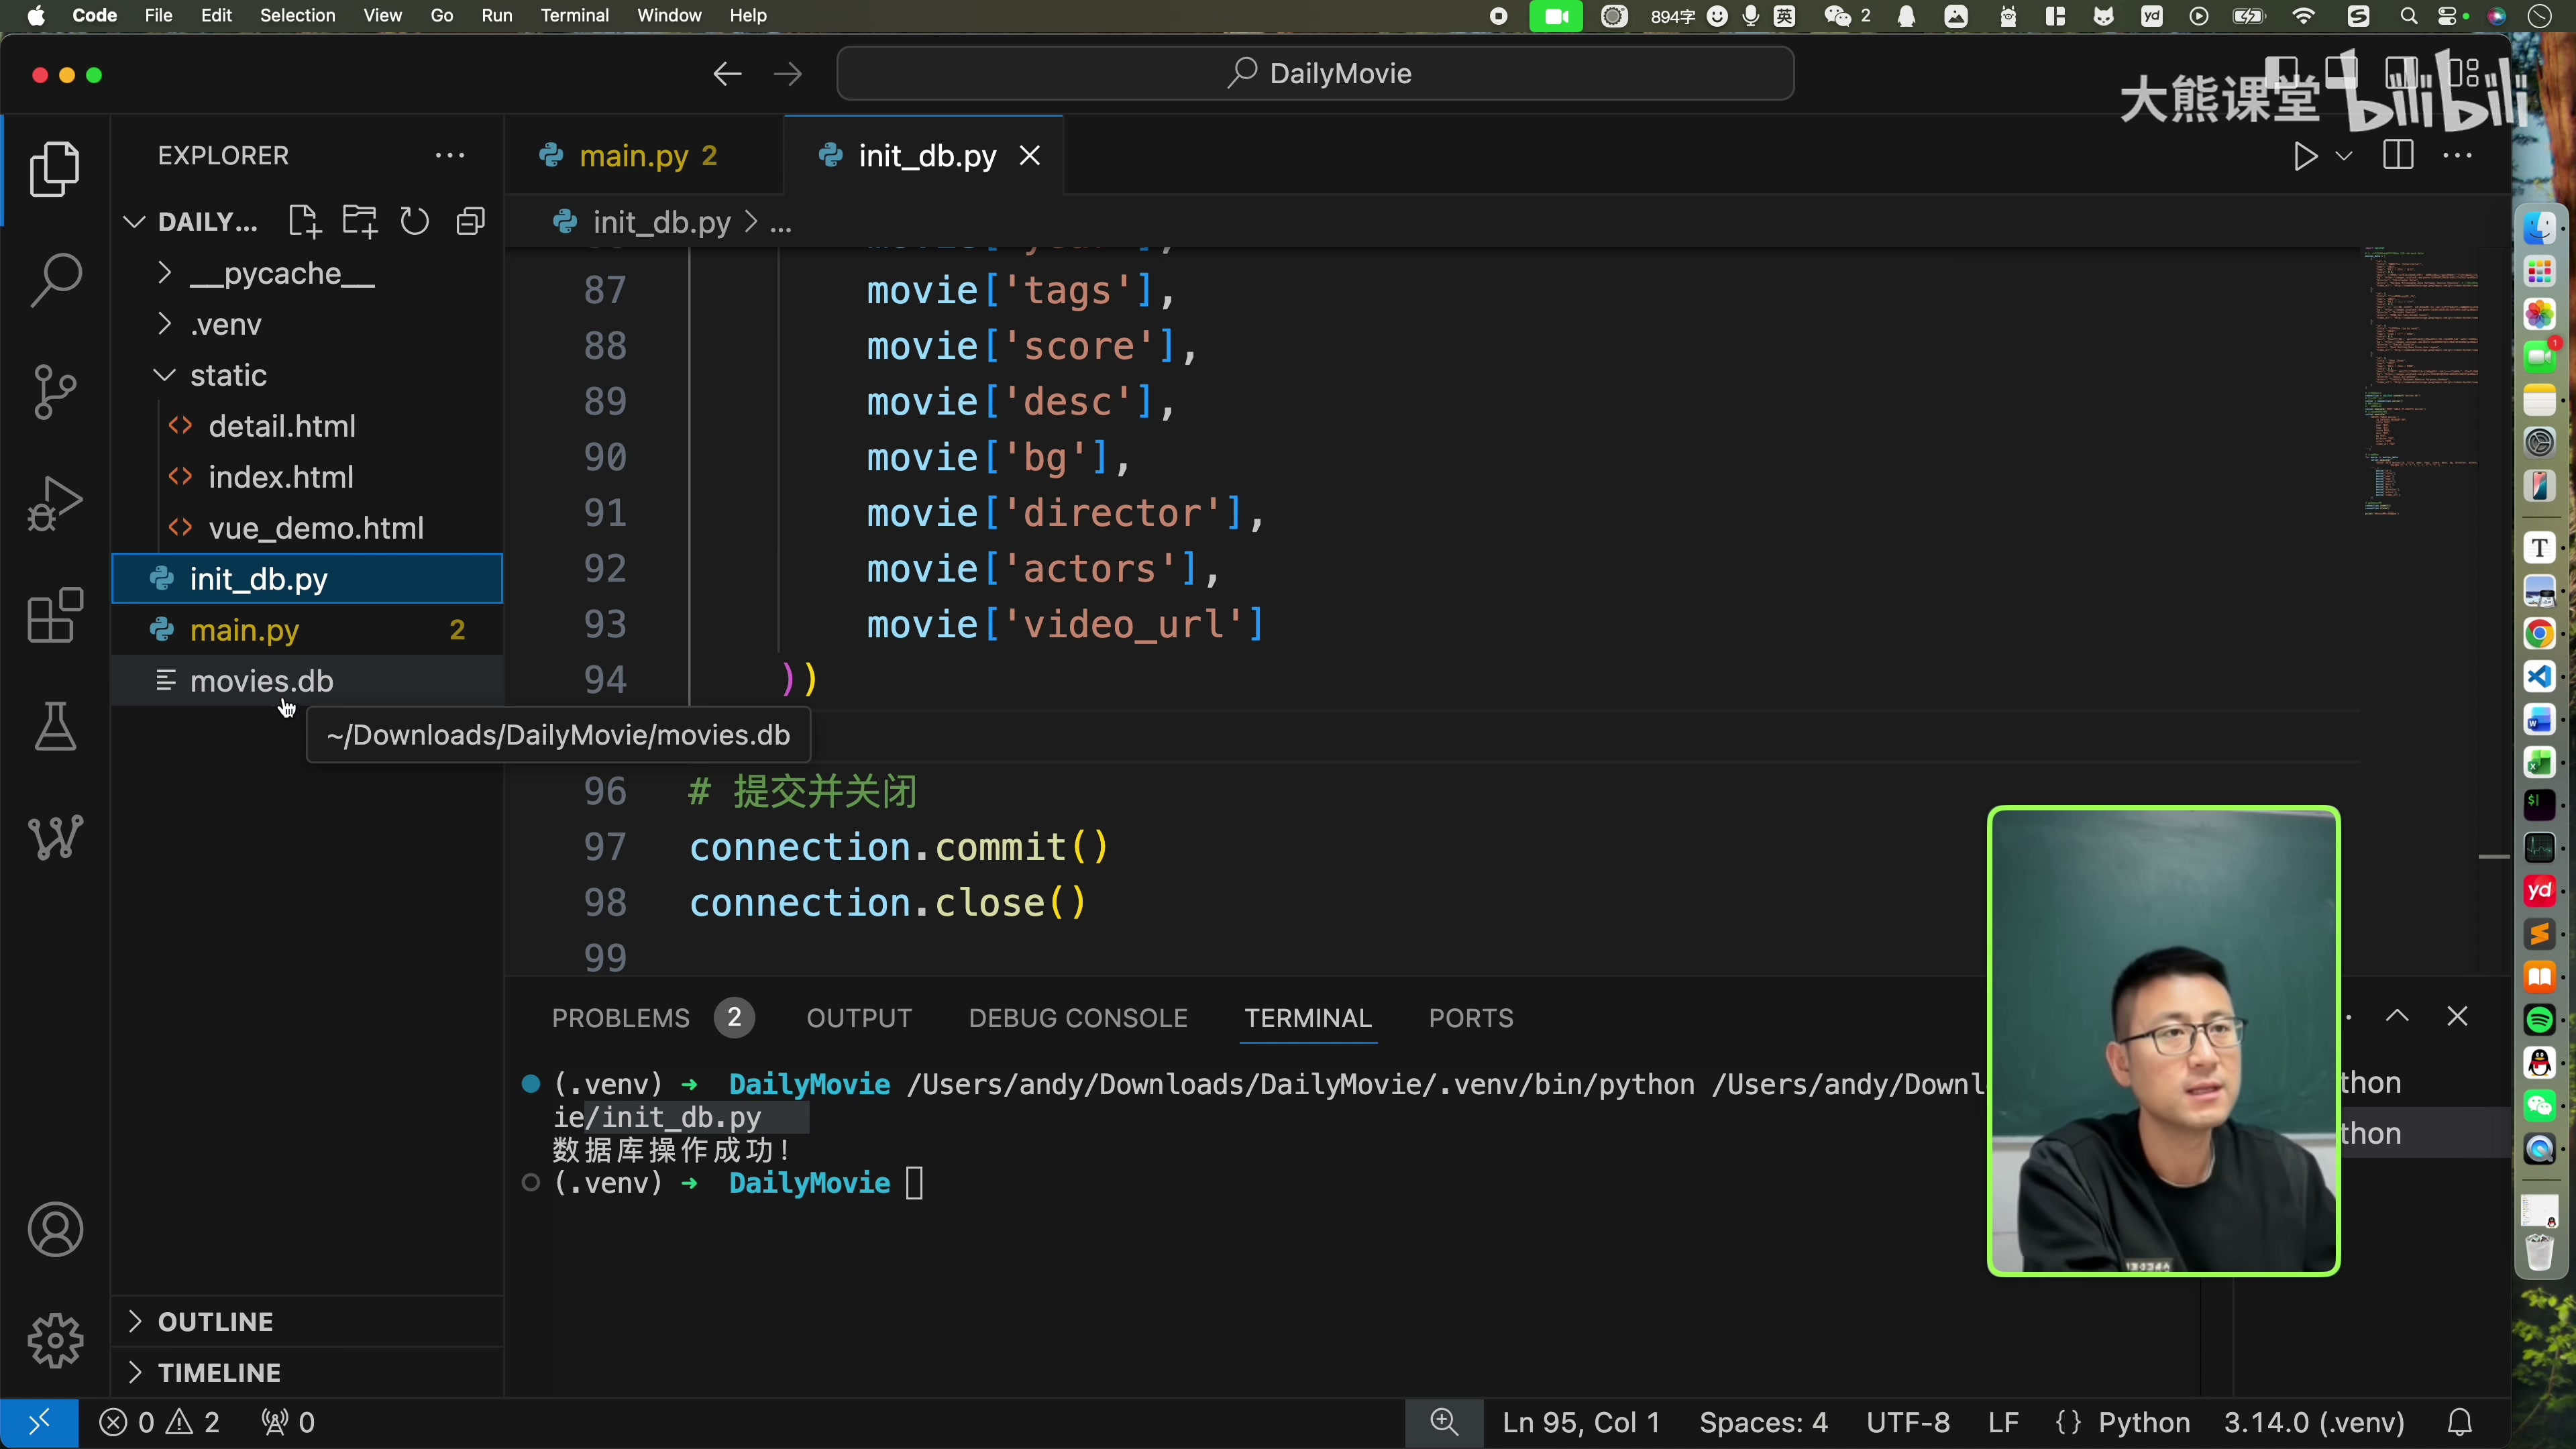
运行 init.py,终端输出"数据库操作成功",同时项目目录下新增了 movies.db 文件——这就是我们的数据库文件。
三、用 Navicat 可视化验证数据
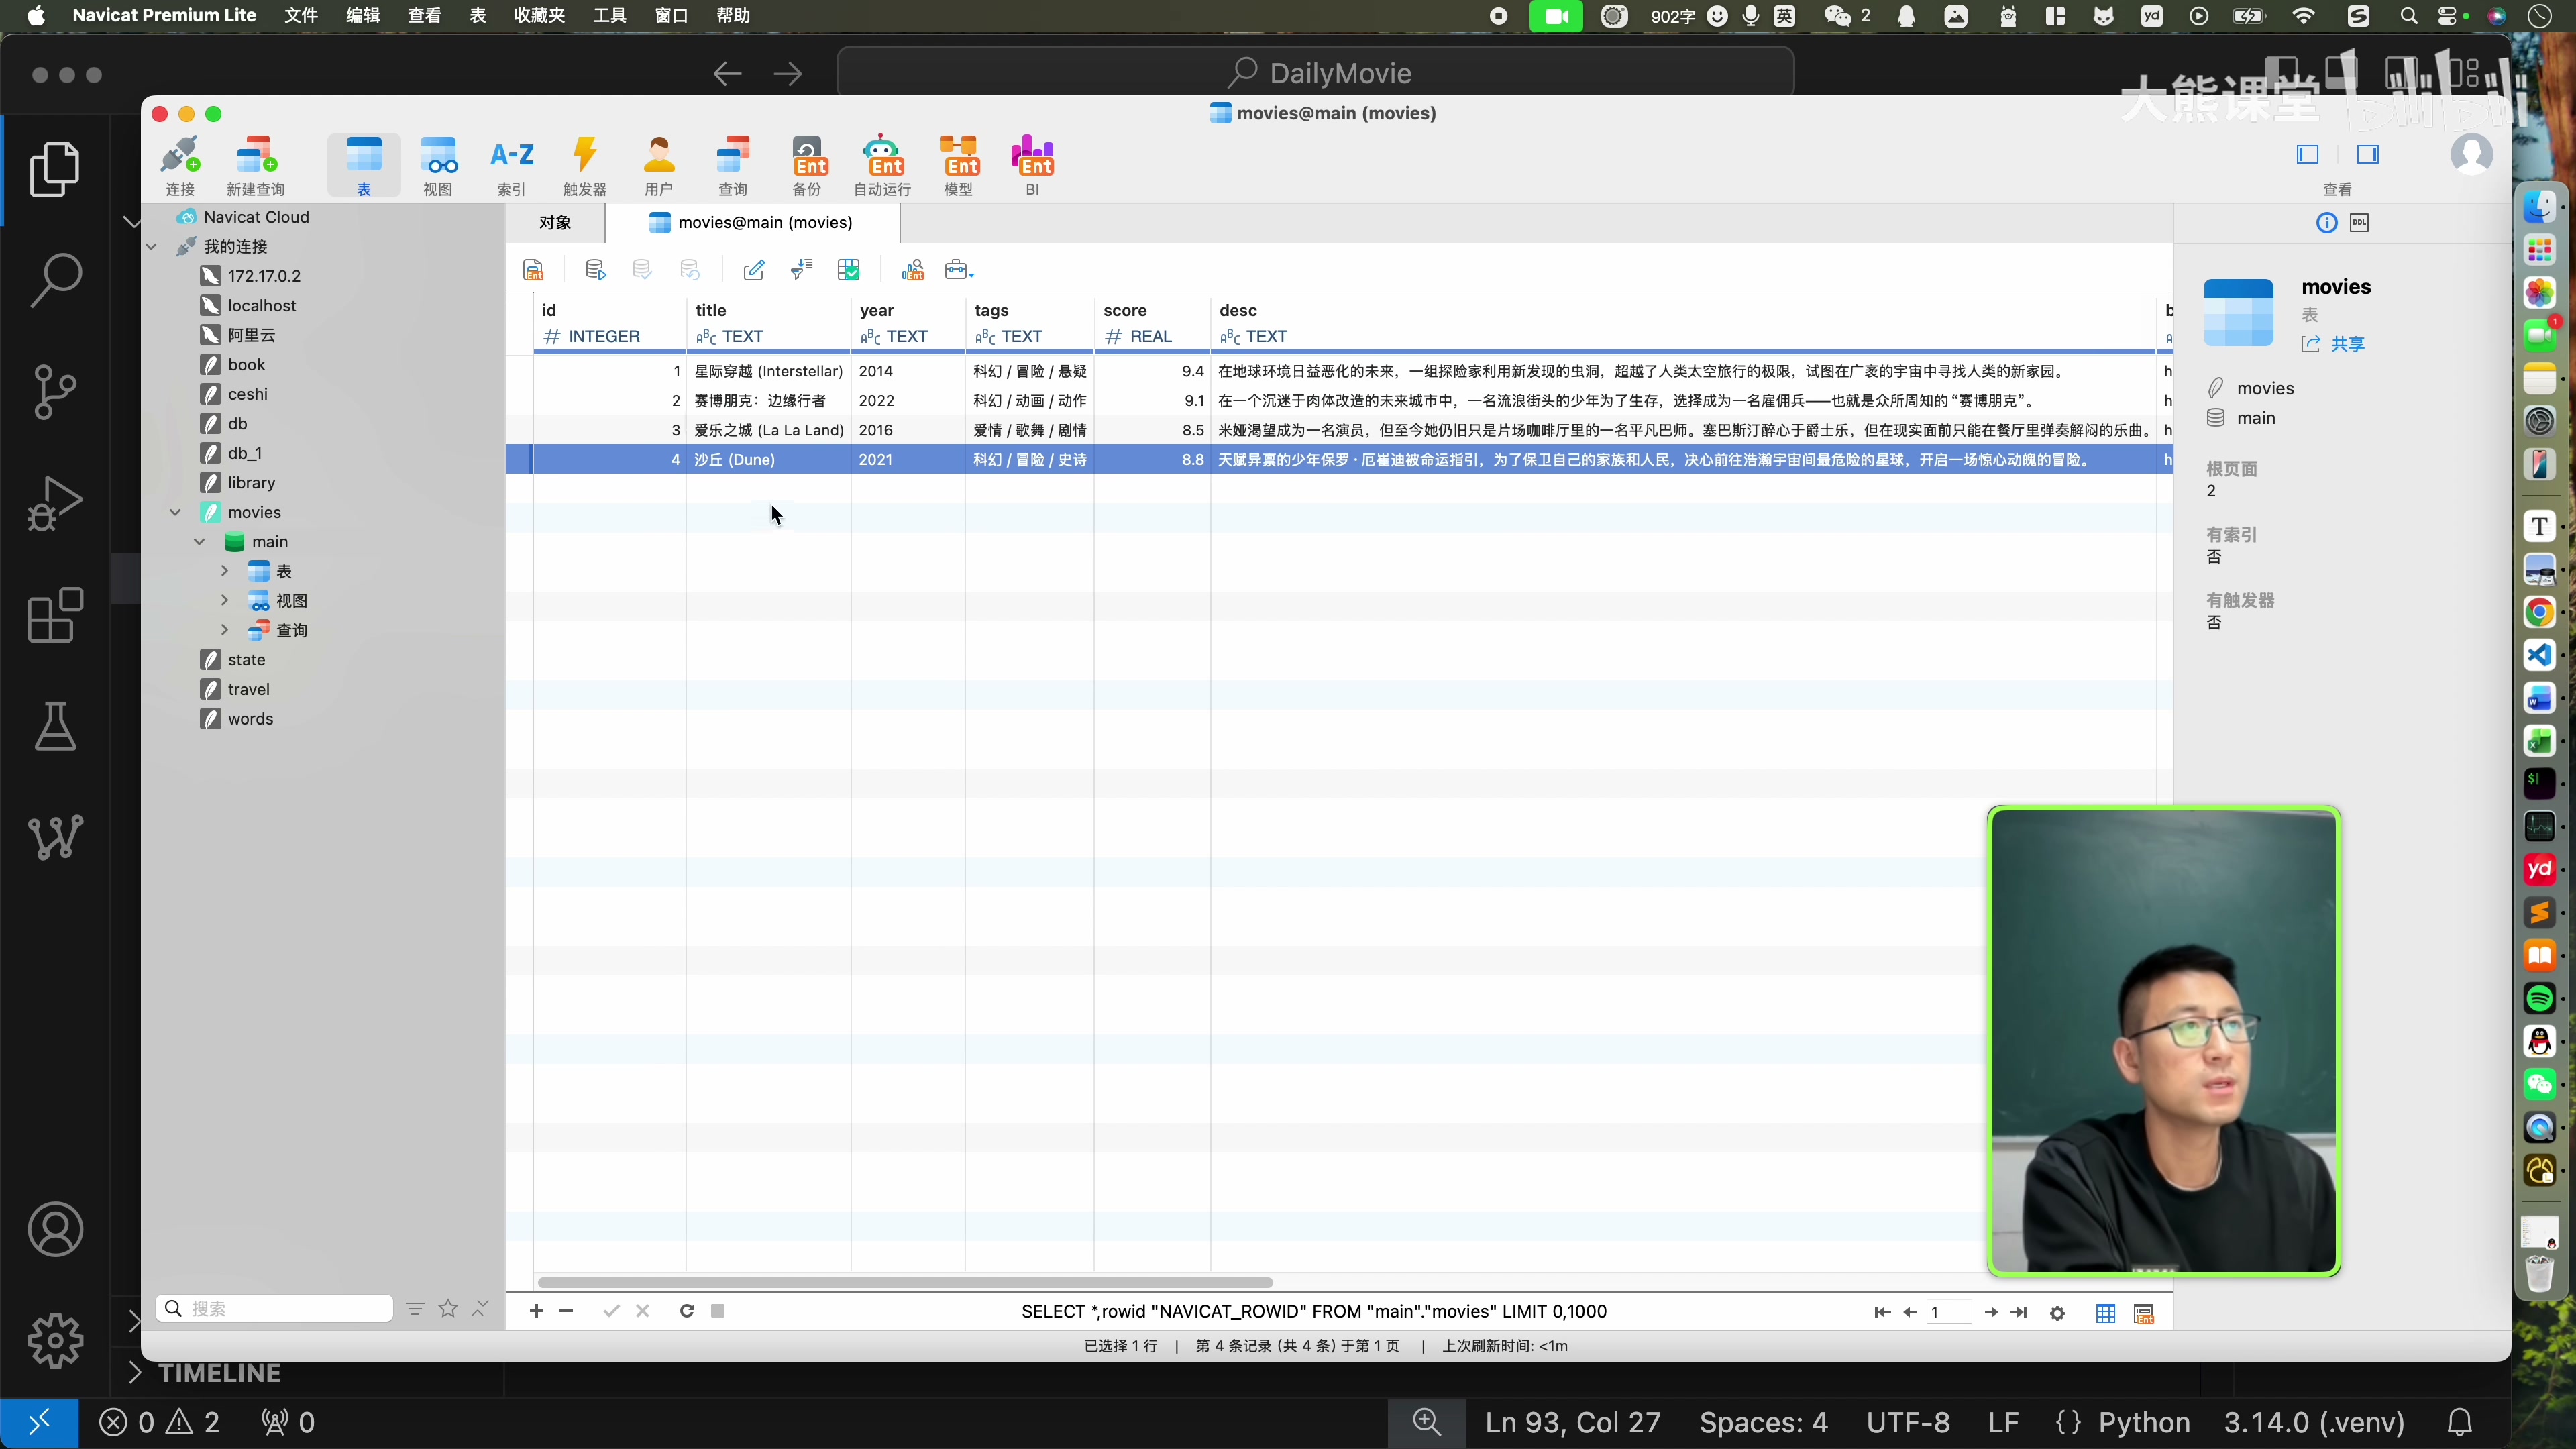
打开 Navicat,新建 SQLite 连接,选择"现有数据库文件",指向项目目录下的 movies.db。连接成功后双击打开,可以看到新增的 movies 表,字段包括 id、title、year、tags、score、description、cover、director、actors、video_url。
以列表形式查看表数据,每一行就是一条电影记录,原来的假数据已全部入库。
四、改造 main.py:从数据库读取数据
数据准备好后,回到 main.py,先写一个获取数据库连接的公共方法,再改造随机推荐和详情两个接口。
1. 封装数据库连接方法
import sqlite3

def get_db_connection():
    connection = sqlite3.connect('movies.db')
    # 让查询结果可以像字典一样按字段名访问
    connection.row_factory = sqlite3.Row
    return connection
row_factory = sqlite3.Row 的作用是让查询结果支持 movie["id"]、movie["title"] 这样的字典式访问。
2. 随机推荐接口:SQL 随机排序取一条
先在 Navicat 的查询窗口验证 SQL 是否正确:
SELECT * FROM movies ORDER BY RANDOM() LIMIT 1;
多次运行,每次返回的记录都不同,说明语句可用。建议先在可视化工具里验证 SQL,再写进 Python 代码,这样排查问题时能快速区分是 SQL 错误还是代码错误。
确认无误后写入接口:
@app.get('/api/movie/random')
async def get_random_movie():
    # 从sqlite中随机筛选一条记录
    connection = get_db_connection()
    random_sql = "SELECT * FROM movies ORDER BY RANDOM() LIMIT 1"
    movie = connection.execute(random_sql).fetchone()
    connection.close()

    if not movie:
        raise HTTPException(status_code=404, detail='没有获取到电影')

    return format_movie(movie)
这里 connection.execute() 会自动创建游标,因此省略了手动 cursor 的步骤。
3. 详情接口:按 ID 查询
同样先在 Navicat 验证:
SELECT * FROM movies WHERE id = 4;
确认后写入代码,注意 ID 是动态的,必须用 ? 占位符并以元组传参(单元素元组也要带逗号):
@app.get('/api/movie/{movie_id}')
async def get_movie_by_id(movie_id: int):
    connection = get_db_connection()
    fetch_sql = "SELECT * FROM movies where id = ?"
    movie = connection.execute(fetch_sql,(movie_id,)).fetchone()
    connection.close()

    if not movie:
        raise HTTPException(status_code=404, detail='没有获取到电影')

    return format_movie(movie)
五、启动测试与问题修复
启动服务:
uvicorn main:app --reload
问题一:页面空白,SQL 变量引用顺序错误
首次刷新页面没有任何输出。查看终端报错,提示 random_sql 在定义之前就被引用——把变量定义挪到使用之前即可,保存后服务自动重启。
问题二:演员列表显示异常
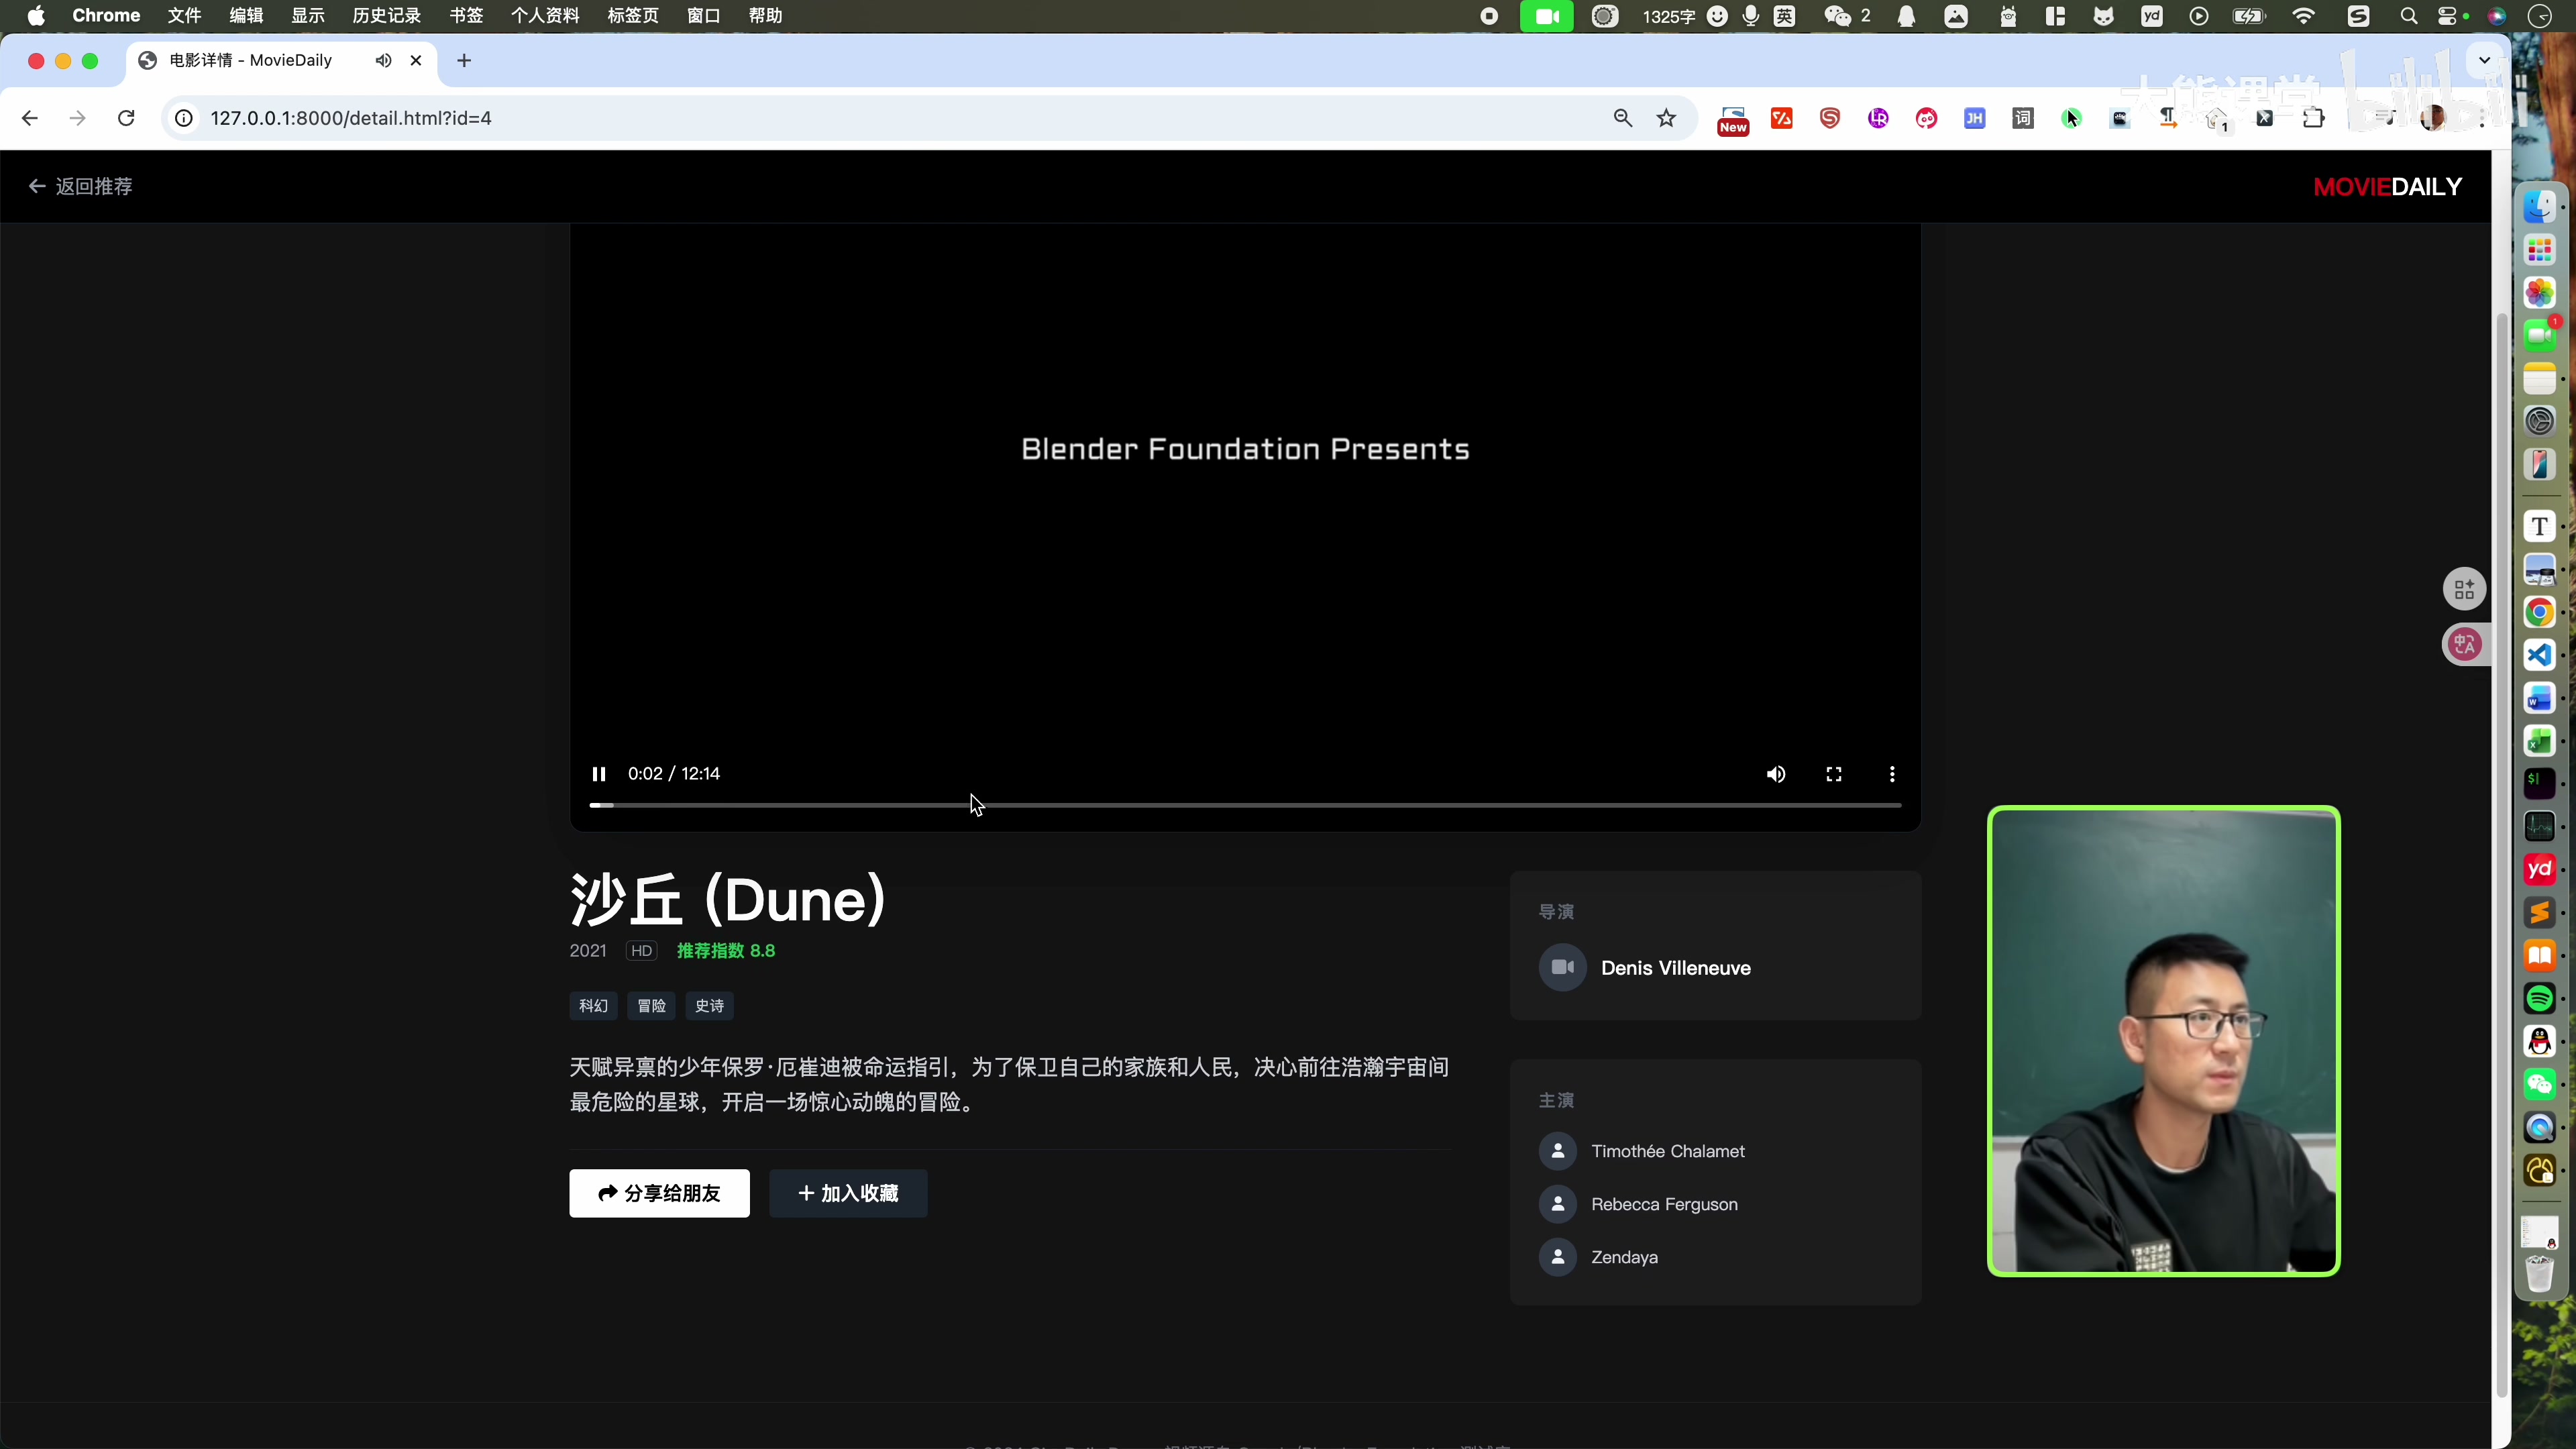
修复后刷新,随机推荐正常,每次都是不同电影;点击"立即观看"进入详情页,能正确显示《沙丘》《星际穿越》《赛博朋克》等影片。
但详情页的演员列表显示成了整段字符串。原因是数据库里 actors 字段存的是逗号分隔的字符串,而前端需要列表。为此在连接方法下方新增一个统一的格式转换方法:
def format_movie(movie_row):
    """处理actors字段"""
    movie_dict = dict(movie_row)
    if movie_dict.get('actors'):
        movie_dict['actors'] = movie_dict['actors'].split(',')
    return movie_dict
在两个接口返回前分别调用 format_movie(movie)。刷新页面后,演员列表恢复正常显示。
六、新增数据验证动态效果
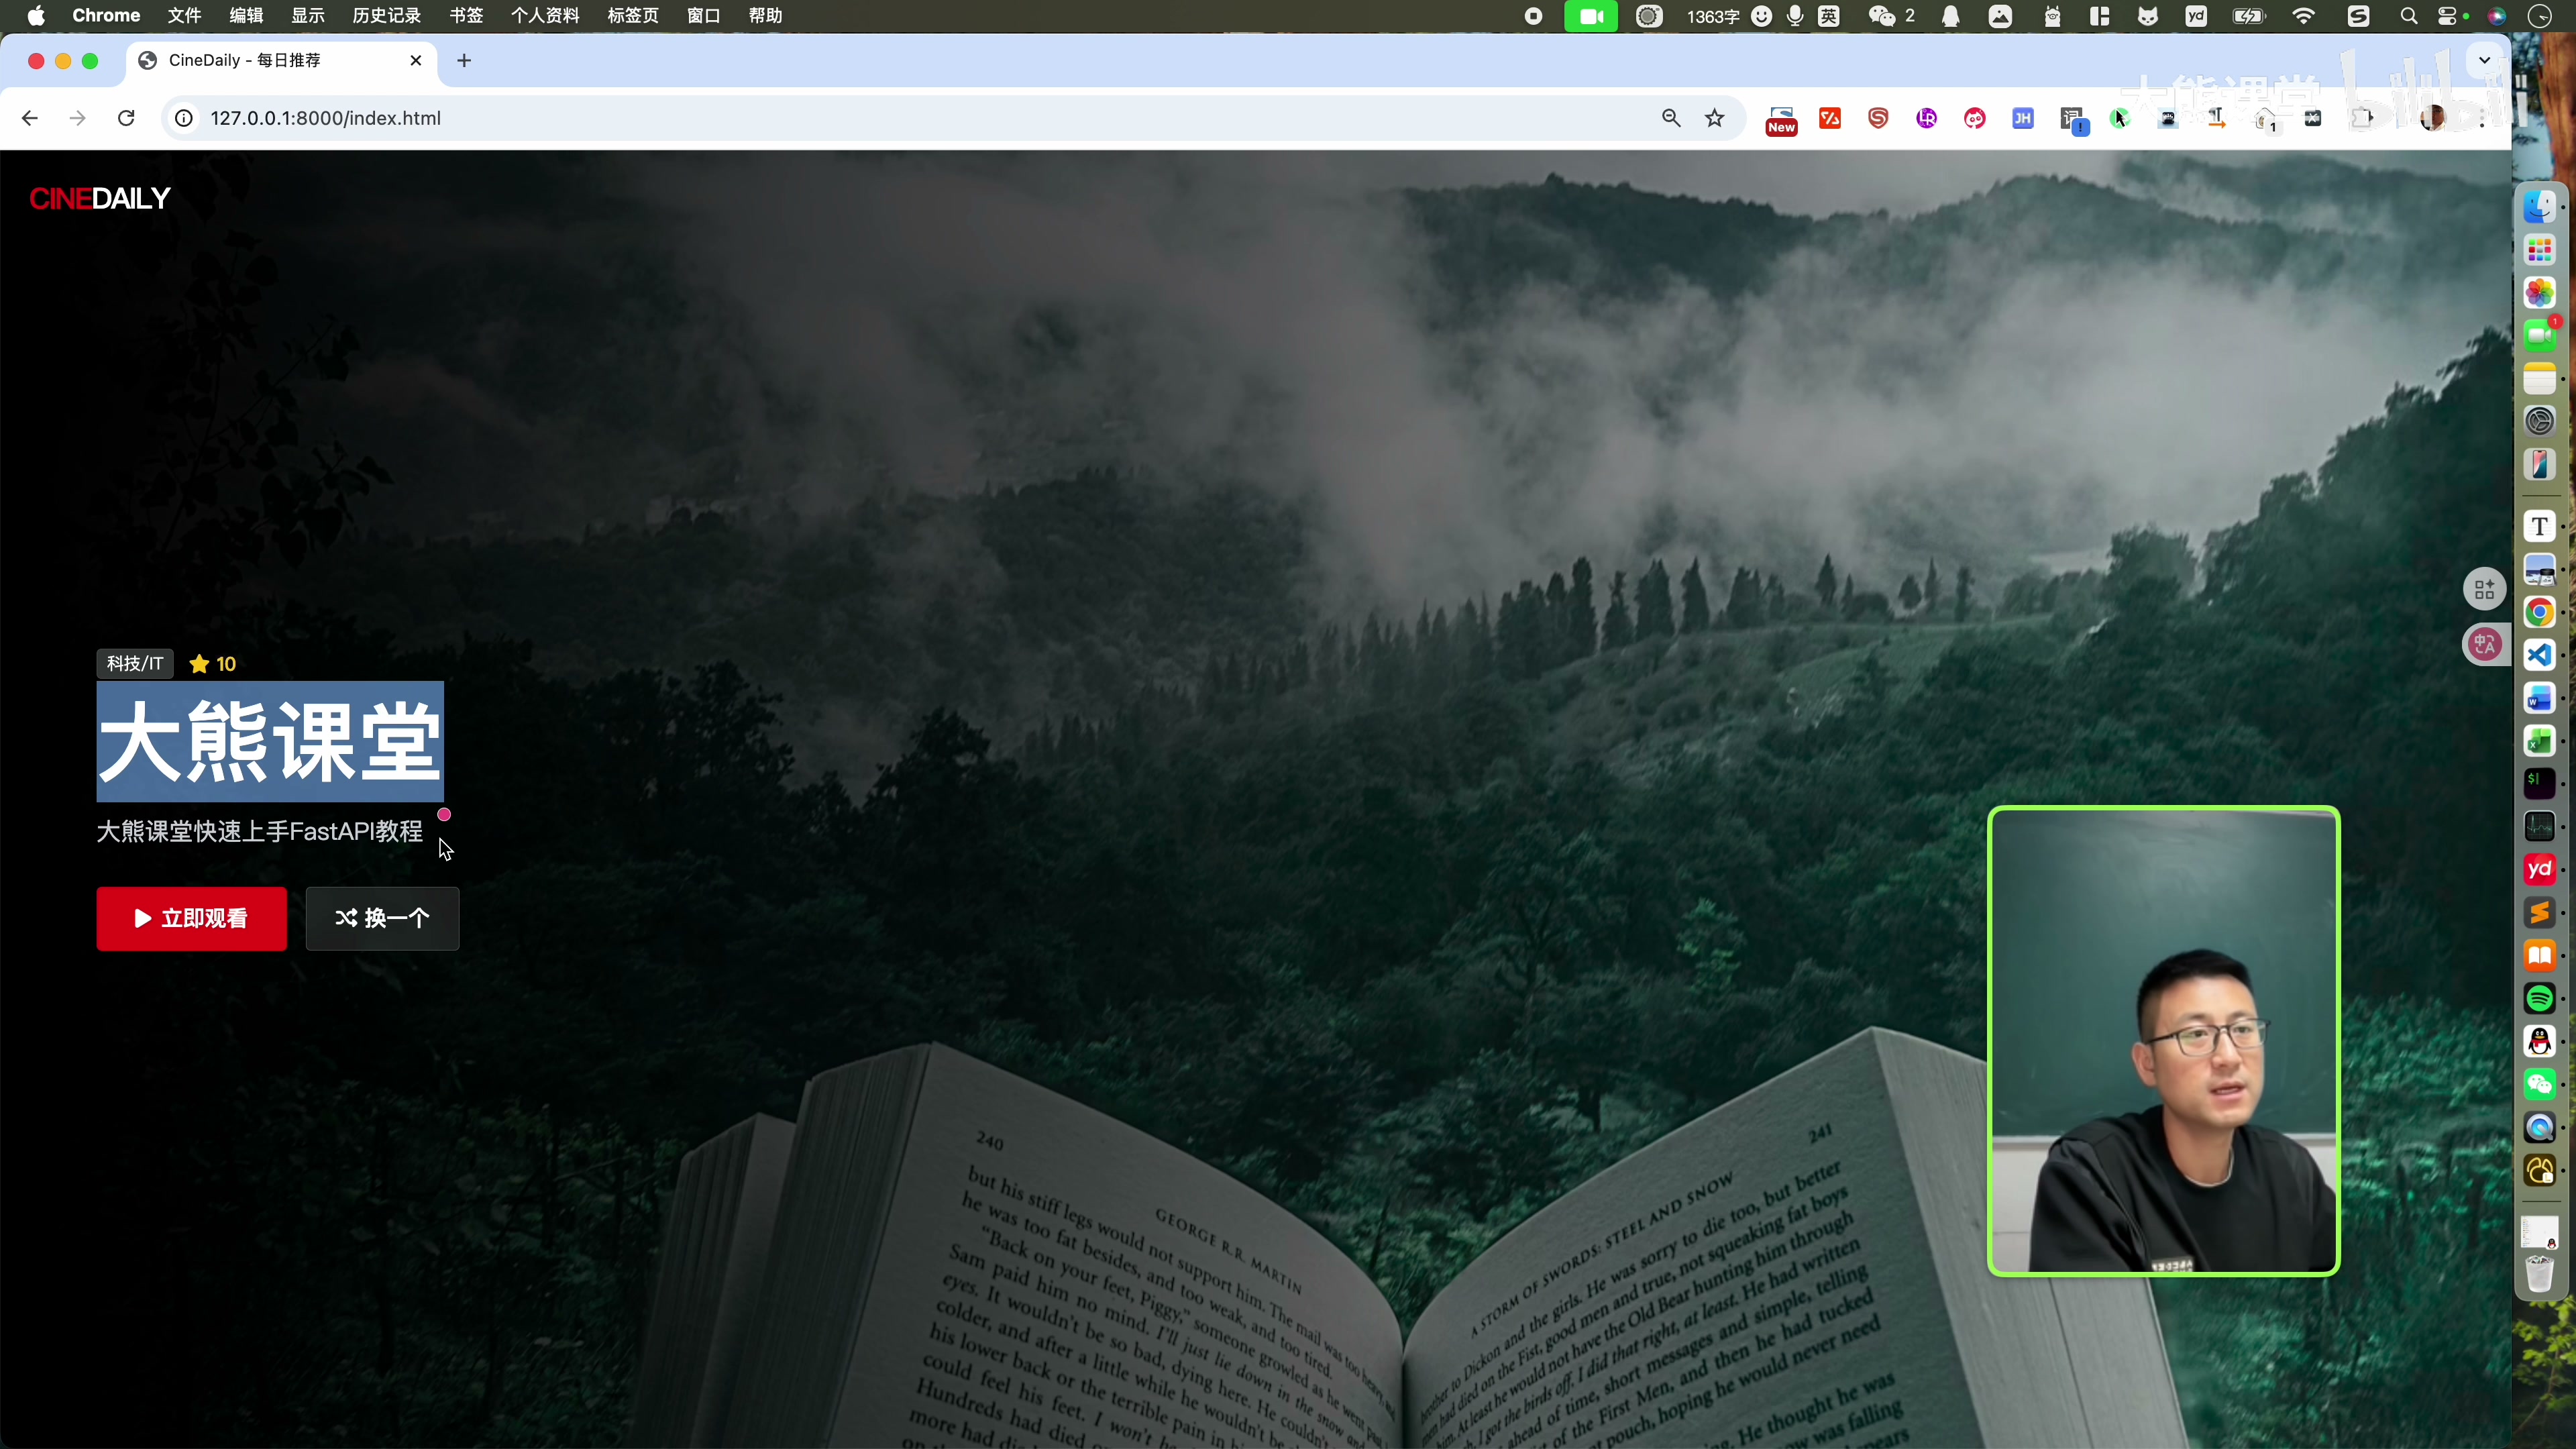
为了验证数据真正由数据库驱动,在 Navicat 中直接插入一条新记录:ID 为 5,片名"大熊课堂",年份 2025,标签科技/IT,评分 10 分,并补充封面、简介、导演、演员等信息。
回到网站刷新首页,随机推荐中出现了"大熊课堂",评分 10 分,点击进入详情页也能正常展示。这说明首页和详情页的数据完全来自数据库,新增记录会即时生效。
小结
本节完成了数据从代码到数据库的"搬家":
- 删除
main.py中的硬编码电影数据; - 编写
init.py,用sqlite3建库建表并批量插入数据,插入时使用?占位符防止 SQL 注入; - 用 Navicat 可视化确认数据入库,并养成"先验证 SQL、再写代码"的调试习惯;
- 在
main.py中封装连接方法,用ORDER BY RANDOM() LIMIT 1实现随机推荐、用WHERE id = ?实现详情查询; - 通过
format_movie统一处理演员字段的字符串转列表; - 在数据库中新增记录后刷新页面,验证了数据的动态生效。
至此,网站的数据层已切换为 SQLite,后续增删改查都只需操作数据库即可。
想系统学习这门课程?
你已阅读完本文。需要更完整的知识体系,可以继续了解「FastAPI 项目实战」。
查看课程详情