第六章:完善 Health Tracker——实现饮食记录的查询、修改和删除
上一章,我们已经将本地 MCP Server 连接到了 ChatGPT。
现在,我们可以直接告诉 ChatGPT:
今天早餐吃了一根香蕉,帮我估算热量并记录。
ChatGPT 会识别食物、估算营养成分,再调用我们编写的 record_food 工具,将数据保存到 SQLite 数据库中。
但是,实际使用几天后,我发现了一个新问题。
昨天中午,我告诉 ChatGPT 吃了 200 克米饭。后来想起来,实际上只吃了 100 克。
这时候应该怎么办?
如果再调用一次 record_food,数据库中就会多出一条米饭记录,而不是修改原来的数据。
同样,如果不小心记录了两次香蕉,也需要能够删除其中一条。
所以,一个真正可用的 Health Tracker,不能只有新增和查询功能,还需要支持修改和删除。
本章目标:
- 根据日期、餐次和食物名称查找记录。
- 使用记录 ID 精确定位数据。
- 开发
update_food工具,修改已有记录。 - 开发
delete_food工具,删除指定记录。 - 防止误修改、误删除和 SQL 注入。
- 在 ChatGPT 中测试完整的增删改查流程。
6.1 为什么修改数据之前,必须先查找?
我们先看一个例子。
假设 SQLite 中已经保存了以下记录:
| id | 日期 | 餐次 | 食物 | 热量 |
|---|---|---|---|---|
| 1 | 2026-10-19 | 午餐 | 米饭 | 232 |
| 2 | 2026-10-19 | 晚餐 | 米饭 | 116 |
| 3 | 2026-10-20 | 午餐 | 米饭 | 232 |
| 4 | 2026-10-20 | 早餐 | 香蕉 | 105 |
现在用户告诉 ChatGPT:
昨天中午的米饭不是 200 克,而是 100 克,帮我修改。
问题来了。
数据库中有三条米饭记录,究竟应该修改哪一条?
我们不能简单地根据 food_name = '米饭' 更新数据,否则可能同时修改多条记录。
正确做法应该分成两步。
第一步,查找满足条件的记录。
第二步,根据唯一的记录 ID 执行修改。
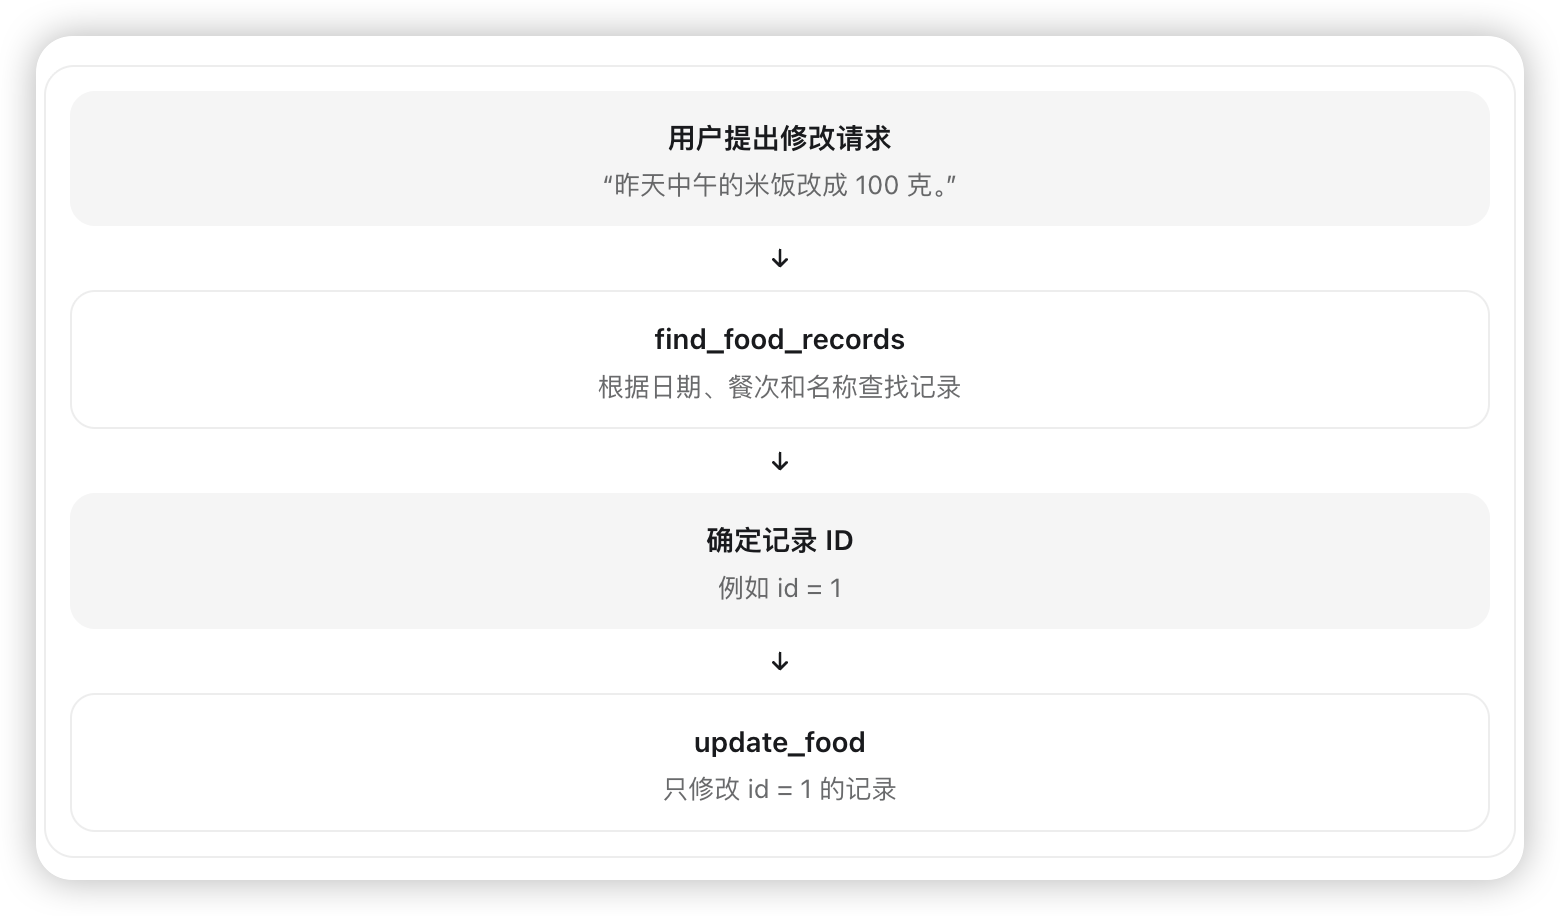
因此,本章首先开发一个查找工具。
6.2 开发 find_food_records:查找饮食记录
打开 db.py。
我们先编写数据库查询函数。
第一步:实现多条件查询
def find_food_records_db(
    record_date: str | None = None,
    meal_type: str | None = None,
    food_name: str | None = None,
    limit: int = 20,
) -> list[dict]:

    sql = """
        SELECT *
        FROM food_records
        WHERE 1 = 1
    """

    params = []

    if record_date is not None:
        sql += " AND record_date = ?"
        params.append(record_date)

    if meal_type is not None:
        sql += " AND meal_type = ?"
        params.append(meal_type)

    if food_name is not None:
        sql += " AND food_name LIKE ?"
        params.append(f"%{food_name}%")

    sql += " ORDER BY record_date DESC, id DESC LIMIT ?"
    params.append(limit)

    with get_connection() as conn:
        rows = conn.execute(sql, params).fetchall()
        return [dict(row) for row in rows]
这里有几个值得注意的知识点。
为什么使用 WHERE 1 = 1?
SELECT *
FROM food_records
WHERE 1 = 1
1 = 1 永远成立。
这样做主要是为了方便动态拼接查询条件。
例如,用户只提供日期:
WHERE 1 = 1
AND record_date = ?
如果用户还提供餐次:
WHERE 1 = 1
AND record_date = ?
AND meal_type = ?
这样就不需要额外判断第一个条件应该使用 WHERE,还是后续条件应该使用 AND。
为什么使用 LIKE?
food_name LIKE ?
它支持模糊匹配。
例如用户搜索:
米饭
就有可能找到:
白米饭
糙米饭
米饭
但要注意,这种模糊查询只是字符串匹配,并不具备语义理解能力。
例如,搜索“鸡肉”不一定能找到“鸡腿”。
ChatGPT 可以帮助理解用户的表达,但数据库最终仍然按照 SQL 条件查询。
为什么限制查询数量?
limit: int = 20
因为我们不希望用户随意发起一次无限量的数据查询。
对于个人健康记录系统,一次返回最近 20 条匹配记录,通常足够用于定位某条数据。
如果后续需要浏览大量历史记录,可以再增加分页功能。
6.3 将查找函数注册为 MCP 工具
打开 main.py,导入:
from db import find_food_records_db
然后增加:
@mcp.tool()
def find_food_records(
    record_date: str | None = None,
    meal_type: str | None = None,
    food_name: str | None = None,
    limit: int = 20,
) -> dict:
    """
    根据日期、餐次和食物名称查找饮食记录。

    当用户要求修改或删除饮食记录时,
    应先使用本工具查找目标记录,
    获取准确的记录 ID。

    参数:
    - record_date:日期 YYYY-MM-DD,可选
    - meal_type:breakfast/lunch/dinner/snack,可选
    - food_name:食物名称,支持模糊匹配,可选
    - limit:最大返回数量,范围 1~100
    """

    try:
        if record_date is not None:
            valid_date(record_date)

        allowed_meals = {
            "breakfast",
            "lunch",
            "dinner",
            "snack",
        }

        if meal_type is not None and meal_type not in allowed_meals:
            raise ValueError("无效的餐次")

        if not 1 <= limit <= 100:
            raise ValueError("limit 必须在 1~100 之间")

        if food_name is not None and not food_name.strip():
            raise ValueError("食物名称不能为空字符串")

        if all(
            value is None
            for value in (record_date, meal_type, food_name)
        ):
            raise ValueError("至少提供一个查询条件")

        records = find_food_records_db(
            record_date=record_date,
            meal_type=meal_type,
            food_name=food_name,
            limit=limit,
        )

        return {
            "success": True,
            "count": len(records),
            "records": records,
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }
现在,ChatGPT 就可以通过日期、餐次和食物名称查找数据库中的记录。
使用 MCP Inspector 测试
重新启动 MCP Server:
uv run python main.py
连接 Inspector,找到 find_food_records。
输入:
{
  "record_date": "2026-10-19",
  "meal_type": "lunch",
  "food_name": "米饭"
}
假设数据库中存在对应记录,返回结果可能是:
{
  "success": true,
  "count": 1,
  "records": [
    {
      "id": 1,
      "record_date": "2026-10-19",
      "meal_type": "lunch",
      "food_name": "米饭",
      "calories": 232,
      "weight_g": 200,
      "protein_g": 5.2,
      "carbs_g": 51.8,
      "fat_g": 0.6,
      "notes": null
    }
  ]
}
现在,我们已经知道应该修改的是 ID 为 1 的记录。
接下来,就可以开发修改功能。
6.4 开发 update_food:修改指定饮食记录
我们先思考一个问题。
如果用户只说:
把这条米饭的重量修改为 100 克。
那么,其他字段应该怎么办?
例如,原来的热量是 232 千卡,蛋白质是 5.2 克。
如果只修改 weight_g,不修改热量和营养成分,就会出现数据不一致。
所以,对于饮食记录,我们需要允许同时修改:
- 食物名称
- 热量
- 重量
- 蛋白质
- 碳水化合物
- 脂肪
- 备注
对于重量发生变化的情况,ChatGPT 应当重新估算相关营养成分,而不是只修改重量字段。
第一步:编写数据库更新函数
打开 db.py,添加:
def update_food_db(
    record_id: int,
    updates: dict,
) -> bool:

    allowed_fields = {
        "food_name",
        "calories",
        "weight_g",
        "protein_g",
        "carbs_g",
        "fat_g",
        "notes",
    }

    if not updates:
        raise ValueError("没有需要修改的字段")

    if not set(updates).issubset(allowed_fields):
        raise ValueError("包含不允许修改的字段")

    assignments = ", ".join(
        f"{field} = ?"
        for field in updates
    )

    sql = f"""
        UPDATE food_records
        SET {assignments}
        WHERE id = ?
    """

    params = list(updates.values()) + [record_id]

    with get_connection() as conn:
        cursor = conn.execute(sql, params)
        return cursor.rowcount > 0
这里使用了 SQL 的 UPDATE 语句。
例如:
UPDATE food_records
SET weight_g = ?, calories = ?
WHERE id = ?
注意,我们虽然使用了字符串拼接生成字段名称,但字段必须来自预先定义的 allowed_fields 白名单。
而真正的数据值仍然通过 SQL 参数占位符传入。
这样可以避免让客户端任意指定 SQL 字段或拼接恶意 SQL 语句。
第二步:注册 update_food 工具
打开 main.py:
from db import update_food_db
继续添加:
@mcp.tool()
def update_food(
    record_id: int,
    food_name: str | None = None,
    calories: float | None = None,
    weight_g: float | None = None,
    protein_g: float | None = None,
    carbs_g: float | None = None,
    fat_g: float | None = None,
    notes: str | None = None,
) -> dict:
    """
    根据记录 ID 修改饮食记录。

    修改前应先调用 find_food_records,
    确认目标记录 ID。

    如果用户修改食物重量,应尽可能同步重新估算
    热量、蛋白质、碳水和脂肪。

    未提供的字段保持不变。
    """

    try:
        if record_id <= 0:
            raise ValueError("record_id 必须大于 0")

        if food_name is not None and not food_name.strip():
            raise ValueError("食物名称不能为空")

        check_nonnegative(
            calories=calories,
            weight_g=weight_g,
            protein_g=protein_g,
            carbs_g=carbs_g,
            fat_g=fat_g,
        )

        updates = {
            "food_name": food_name,
            "calories": calories,
            "weight_g": weight_g,
            "protein_g": protein_g,
            "carbs_g": carbs_g,
            "fat_g": fat_g,
            "notes": notes,
        }

        updates = {
            key: value
            for key, value in updates.items()
            if value is not None
        }

        updated = update_food_db(
            record_id=record_id,
            updates=updates,
        )

        if not updated:
            return {
                "success": False,
                "error": "没有找到对应记录",
            }

        return {
            "success": True,
            "record_id": record_id,
            "updated_fields": list(updates),
            "message": "饮食记录修改成功",
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }
这里有一个设计细节:
if value is not None
意味着未提供的字段不会被修改。
例如,只传入:
{
  "record_id": 1,
  "notes": "午餐实际食用量为100克"
}
那么,其他营养字段都会保持原值。
但这种接口也有一个限制:目前无法通过传入 None 主动清空已有字段。
因为我们将 None 同时用于表示“没有提供参数”。
为了保持本章代码简单,暂时采用这种设计。后面如果需要支持将某个字段重置为数据库 NULL,可以使用显式的字段更新对象或单独的清空字段参数。
6.5 测试修改饮食记录
假设数据库中原来有一条米饭记录:
| 字段 | 原始值 |
|---|---|
| id | 1 |
| food_name | 米饭 |
| weight_g | 200 |
| calories | 232 |
| protein_g | 5.2 |
| carbs_g | 51.8 |
| fat_g | 0.6 |
现在发现实际只吃了 100 克。
如果假设是同一种米饭、相同烹饪方式,可以先按照重量比例估算:
新营养值 = 原营养值 × 100 ÷ 200
因此,新热量约为:
232 × 100 ÷ 200 = 116 kcal
蛋白质、碳水和脂肪也可以按相同比例调整。
在 MCP Inspector 中调用:
update_food
输入:
{
  "record_id": 1,
  "weight_g": 100,
  "calories": 116,
  "protein_g": 2.6,
  "carbs_g": 25.9,
  "fat_g": 0.3,
  "notes": "原记录200克,实际食用100克,营养按比例重新估算"
}
如果成功,应该返回:
{
  "success": true,
  "record_id": 1,
  "updated_fields": [
    "calories",
    "weight_g",
    "protein_g",
    "carbs_g",
    "fat_g",
    "notes"
  ],
  "message": "饮食记录修改成功"
}
之后再次调用 find_food_records,确认数据库中确实已经更新。
需要注意,这里按比例调整营养的前提是食物本身和烹饪方式没有变化。
如果用户把“米饭”改成“炒饭”,就不能简单按重量比例计算,因为炒饭可能添加了食用油、鸡蛋等配料。
6.6 开发 delete_food:删除指定记录
接下来,我们开发删除功能。
假设用户告诉 ChatGPT:
刚才那条香蕉是测试数据,帮我删除。
这时,我们仍然需要先查找记录,确认 ID。
然后执行:
DELETE FROM food_records
WHERE id = ?
第一步:编写数据库删除函数
在 db.py 中添加:
def delete_food_db(record_id: int) -> bool:
    with get_connection() as conn:
        cursor = conn.execute(
            """
            DELETE FROM food_records
            WHERE id = ?
            """,
            (record_id,),
        )

        return cursor.rowcount > 0
这里使用记录 ID 删除。
不会根据食物名称批量删除。
因此,即使用户一天吃了三次香蕉,也可以准确删除其中一条。
第二步:注册 MCP 删除工具
在 main.py 中导入:
from db import delete_food_db
然后添加:
@mcp.tool()
def delete_food(
    record_id: int,
) -> dict:
    """
    根据记录 ID 删除一条饮食记录。

    删除前必须先通过 find_food_records
    确认目标记录。

    如果存在多条可能匹配的记录,
    应要求用户明确要删除哪一条。

    此操作会从 SQLite 中永久删除记录。
    """

    try:
        if record_id <= 0:
            raise ValueError("record_id 必须大于 0")

        deleted = delete_food_db(record_id)

        if not deleted:
            return {
                "success": False,
                "error": "记录不存在",
            }

        return {
            "success": True,
            "record_id": record_id,
            "message": "饮食记录删除成功",
        }

    except ValueError as exc:
        return {
            "success": False,
            "error": str(exc),
        }
现在,我们就拥有了删除工具。
但这里有一个重要的安全问题。
删除操作通常不可逆。
如果用户表达不明确,ChatGPT 不应该随便猜测记录 ID。
例如:
把之前那条米饭删掉。
如果数据库中存在多条米饭记录,就应该先询问用户究竟要删除哪一条。
对于可能产生严重后果的操作,还应该考虑增加二次确认、软删除或审计日志。
本课程当前采用的是直接删除,因此测试时建议使用专门创建的测试记录。
6.7 使用 ChatGPT 完成自然语言修改
现在,我们已经完成了三个工具:
find_food_records
update_food
delete_food
接下来,需要重新启动 MCP Server:
uv run python main.py
然后在 ChatGPT 中进入 Health Tracker 插件管理页面,刷新工具定义。
因为我们新增了工具,ChatGPT 需要重新获取 MCP Server 的工具列表。
测试场景:修改昨天的米饭
在 ChatGPT 中输入:
昨天中午记录的米饭是 200 克,实际上只有 100 克。请帮我找到这条记录,并同步修改热量和营养成分。
理想情况下,ChatGPT 会先调用:
find_food_records
参数类似:
{
  "record_date": "2026-10-19",
  "meal_type": "lunch",
  "food_name": "米饭"
}
注意,这里的日期只是课程示例。实际使用时,“昨天”应根据用户当前日期和时区解析。
如果查询结果只有一条,ChatGPT 就能够获得准确的记录 ID。
接下来,ChatGPT 根据原来的重量和营养数据重新估算,并调用:
update_food
例如:
{
  "record_id": 1,
  "weight_g": 100,
  "calories": 116,
  "protein_g": 2.6,
  "carbs_g": 25.9,
  "fat_g": 0.3
}
修改成功后,再根据工具结果回复用户。
整个过程中,我们没有手动填写 JSON。
ChatGPT 负责理解用户需求、查找目标记录和生成修改参数,MCP Server 负责执行数据库更新。
这就是 AI 工具调用在实际业务中的价值。
6.8 使用 ChatGPT 删除测试记录
我们再测试删除功能。
首先,在 ChatGPT 中输入:
帮我记录一条测试饮食:今天下午吃了一根香蕉,热量 105 千卡,备注为“删除功能测试”。
保存成功后,再输入:
找到刚才那条备注为“删除功能测试”的香蕉记录,删除它。
这里有一个值得注意的地方。
我们当前的 find_food_records 只支持日期、餐次和食物名称三个条件,并不支持按照备注搜索。
因此,ChatGPT 可以先根据日期、餐次和食物名称查找,再检查返回结果中的 notes 字段。
如果找到了唯一匹配的记录,就可以调用 delete_food。
如果有多条相似记录,则应该先向用户确认。
删除完成后,再调用 find_food_records 查询。
如果那条记录已经不存在,就说明删除操作成功。
但要注意:查不到记录也可能是查询条件不正确,因此最可靠的方式是同时检查 delete_food 的执行结果。
6.9 为什么不能让 ChatGPT 直接执行 SQL?
学到这里,可能有人会产生一个想法:
既然 ChatGPT 能够理解自然语言,为什么不直接提供一个工具:
@mcp.tool()
def execute_sql(sql: str):
    ...
让 ChatGPT 自己生成 SQL 呢?
例如:
删除昨天中午的米饭。
ChatGPT 直接生成:
DELETE FROM food_records
WHERE record_date = '2026-10-19'
AND meal_type = 'lunch'
AND food_name = '米饭';
看起来确实更加灵活。
但是,这种设计存在明显风险。
首先,模型可能生成错误 SQL。
其次,用户输入或外部内容可能诱导模型执行超出预期的操作。
例如,错误地执行:
DELETE FROM food_records;
就会删除整张表中的所有饮食记录。
如果提供的是不受限制的 SQL 执行接口,还可能修改数据库结构或访问其他敏感数据。
因此,我不建议在这个项目中向 ChatGPT 暴露任意 SQL 执行工具。
相比之下,我们现在的设计更加可控:
| 工具 | 允许执行的操作 |
|---|---|
find_food_records | 受限制的 SELECT 查询 |
update_food | 根据 ID 修改允许的字段 |
delete_food | 根据 ID 删除单条记录 |
ChatGPT 只能通过这些明确设计的接口操作数据库。
工具的能力边界越清晰,越容易进行参数校验、权限控制和安全审计。
这也是开发 MCP Server 时需要特别重视的原则。
6.10 进一步完善:防止记录在修改前发生变化
目前,我们采用的是:
先查询 → 获取 ID → 执行修改
这已经比根据食物名称直接修改安全得多。
但还存在一种特殊情况。
假设 ChatGPT 查询到:
id = 1
米饭 200 克
在 ChatGPT 执行修改之前,用户又通过其他客户端把这条记录修改成了 150 克。
此时,如果 ChatGPT 继续按照旧数据执行修改,就可能覆盖较新的结果。
这类问题通常称为并发更新冲突。
对于当前的单用户教学项目,出现概率不高,但在正式系统中值得考虑。
常见解决方法是乐观锁。
例如,给数据表增加:
updated_at
字段。
每次修改时,同时检查记录 ID 和原来的更新时间。
只有数据没有被其他操作修改过,才允许更新。
本章暂时不实现乐观锁,因为我们的重点是理解 MCP 工具如何完成增删改查。
不过,学员应该知道:记录 ID 可以准确定位数据,但不能单独解决并发更新问题。
6.11 本章工具清单
到目前为止,Health Tracker 已经拥有以下工具:
| 工具 | 功能 |
|---|---|
record_food | 新增饮食记录 |
get_food_records | 查询指定日期的饮食 |
get_daily_calories | 统计每日热量 |
record_exercise | 新增运动记录 |
record_weight | 新增体重记录 |
record_fasting | 新增断食记录 |
get_daily_summary | 查询每日综合健康数据 |
find_food_records | 根据条件查找饮食记录 |
update_food | 修改指定饮食记录 |
delete_food | 删除指定饮食记录 |
其中,饮食记录已经实现完整的 CRUD:
| 操作 | SQL | MCP 工具 |
|---|---|---|
| Create(新增) | INSERT | record_food |
| Read(读取) | SELECT | find_food_records |
| Update(修改) | UPDATE | update_food |
| Delete(删除) | DELETE | delete_food |
这意味着,我们的 Health Tracker 已经从一个简单的饮食记录工具,逐步发展为具备完整数据管理能力的 MCP 应用。
6.12 本章总结
这一章,我们解决了真实使用过程中经常遇到的问题:
如果 AI 保存的数据出现错误,应该如何准确地修改和删除?
我们没有直接让 ChatGPT 执行任意 SQL,而是设计了三个职责明确的 MCP 工具:
find_food_records 负责定位数据,update_food 负责修改指定记录,delete_food 负责删除指定记录。
同时,我们还学习了几个重要的数据库开发原则:
- 使用记录 ID 精确定位数据。
- SQL 数据值使用参数化查询。
- 动态更新字段必须经过白名单限制。
- 修改食物重量时,应同步检查营养数据。
- 删除操作必须防止目标不明确。
- 不要向 AI 暴露没有限制的数据库执行权限。
现在,我们已经能够直接在 ChatGPT 中完成饮食记录的新增、查询、修改和删除。
但还有一个实际问题没有解决。
目前 MCP Server 和 Tunnel Client 都运行在我们的 Mac 上。
只要关闭电脑,ChatGPT 就无法再调用 Health Tracker。
这显然不适合长期使用。
下一章预告:使用 Docker 将 MCP Server 部署到阿里云
下一章,我们将把 Health Tracker 从本地开发环境迁移到云服务器。
具体包括:
- 为 Python MCP Server 编写 Dockerfile。
- 使用 Docker Compose 管理服务。
- 将 SQLite 数据库挂载到持久化目录。
- 在阿里云 ECS 上运行 MCP Server。
- 配置服务自动重启。
- 将 Tunnel Client 迁移到云服务器,或根据安全需求采用 HTTPS 连接。
- 验证关闭 Mac 后,ChatGPT 仍然能够正常使用 Health Tracker。
完成云端部署后,我们的 Health Tracker 就不再依赖本地电脑持续开机,而是成为一个能够长期运行的私人 MCP 服务。
想系统学习这门课程?
你已阅读完本文。需要更完整的知识体系,可以继续了解「Vibe Coding 实战课程」。
查看课程详情